AI web tráfico alto: mejores métodos para escalar servicio IA
El despliegue de una infraestructura capaz de soportar un AI web tráfico alto requiere una planificación técnica rigurosa para evitar la caída de los sistemas. Para lograrlo, es fundamental implementar arquitecturas escalables, gestionar la carga de procesamiento de manera inteligente y asegurar la disponibilidad de los recursos. En este texto, exploraremos las bases de la gestión de cargas masivas, los métodos de escalabilidad y las limitaciones actuales de la infraestructura.
¿Cómo gestionar un AI web tráfico alto?
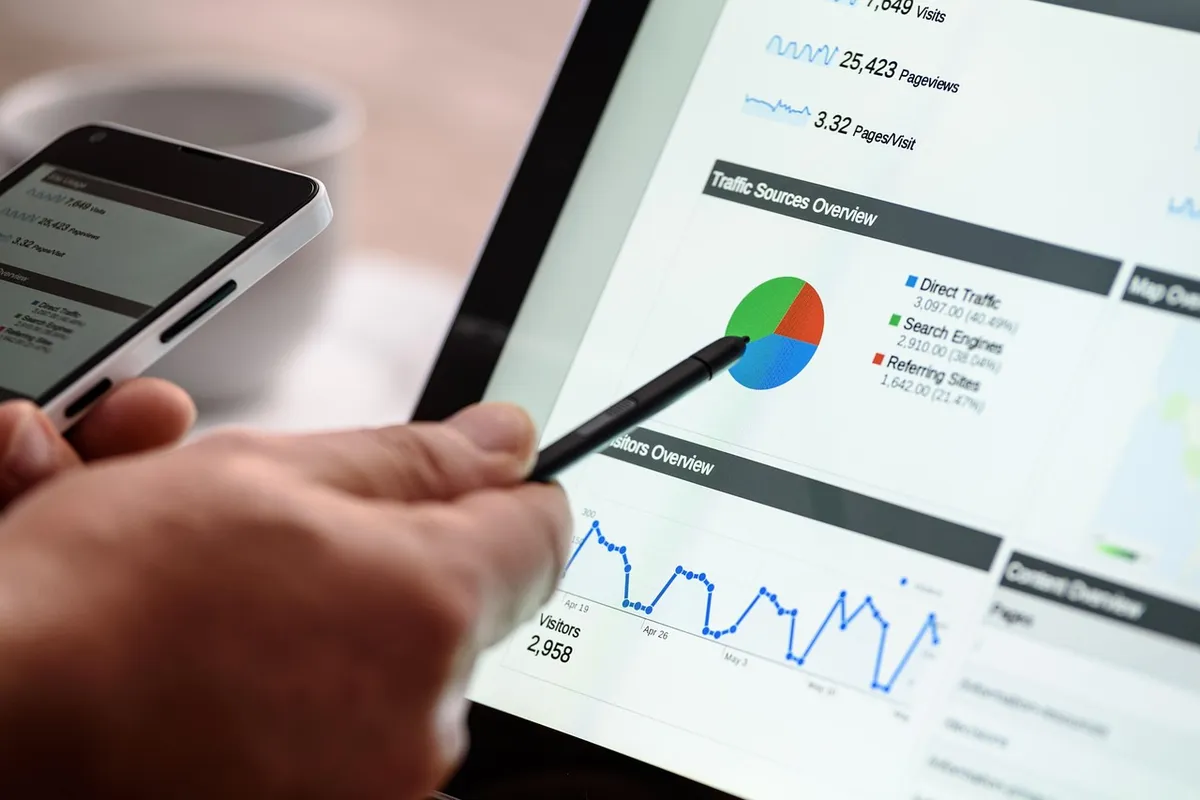
En la oficina oscura, mis manos sudan mientras observo el flujo constante de un AI web tráfico alto en la pantalla.
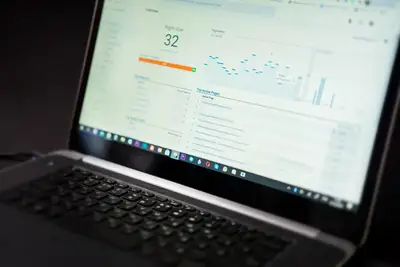
Un monitor de rendimiento parpadea en la pantalla mientras los usuarios acceden simultáneamente a la plataforma. La carga de procesamiento aumenta de forma repentina, exigiendo una respuesta inmediata del servidor para no comprometer la experiencia del usuario.
Gestionar un volumen masivo de solicitudes requiere una estrategia de arquitectura distribuida. El primer paso consiste en separar las capas de presentación de las capas de procesamiento de modelos para que el tráfico de entrada no bloquee las tareas de cómputo.
Es vital implementar sistemas de balanceo de carga que distribuyan las peticiones de forma equitativa entre los nodos disponibles.
Para conseguir un manejo de tráfico de IA efectivo, es necesario emplear colas de mensajes que sirvan como amortiguadores entre la solicitud del usuario y la ejecución del modelo. Esto evita que los picos de demanda saturen la unidad de procesamiento central.
La implementación de cachés de respuesta para consultas frecuentes también reduce la carga de trabajo directa sobre los motores de inteligencia artificial.
- Implementar sistemas de colas para procesar peticiones de forma asíncrona.
- Utilizar balanceadores de carga para distribuir el flujo de entrada.
- Establecer límites de tasa para prevenir la saturación del modelo.
¿Cómo puedo escalar mi servicio de IA?
Un ingeniero observa cómo los nuevos nodos se integran en el clúster de forma automática. El sistema detecta el aumento de latencia y activa la expansión de recursos para mantener la fluidez.
Cuando la demanda supera la capacidad instalada, es necesario escalar servicio IA mediante métodos que permitan un crecimiento dinámico.
Existen dos enfoques principales: el escalado vertical, que implica aumentar los recursos de un servidor existente, y el escalado horizontal, que consiste en añadir más servidores al grupo de trabajo.
En entornos de alta demanda, el escalado horizontal suele ser la opción más robusta. Al añadir múltiples instancias, se puede repartir la carga de manera que ningún componente individual sufra un estrés excesivo.
Esta capacidad de expansión permite que el sistema crezca de acuerdo con la demanda real, optimizando los costos operativos al reducir recursos durante los periodos de baja actividad.
El objetivo es mantener una estabilidad IA alta mediante la redundancia de componentes. Si un nodo falla bajo la presión del tráfico, los otros deben ser capaces de asumir su carga sin interrumpir el servicio.
La automatización de estas tareas mediante orquestadores de contenedores es una práctica estándar para asegurar la continuidad operativa.
¿Cómo diseño sistemas para capacidad de IA masiva?
Un técnico ajusta los parámetros de latencia mientras observa el flujo de datos entrando en el centro de procesamiento. La configuración busca el equilibrio entre la velocidad de respuesta y la integridad de los datos procesados.
El diseño sistema IA escala se basa en la modularidad. Al dividir el sistema en microservicios, se pueden asignar recursos específicos a las tareas más pesadas sin afectar la navegación general del sitio web.
Esto permite que el crecimiento de una parte del sistema no comprometa la integridad de la totalidad.
Para asegurar una capacidad IA masiva, se deben considerar los siguientes aspectos:
- Implementación de sistemas de balanceo de carga de capa 7 para dirigir el tráfico según el tipo de solicitud. 2. Uso de arquitectas de microservicios para aislar procesos de computación intensiva. 3. Configuración de políticas de auto-escalado basadas en métricas de uso de CPU y memoria.
Tras configurar estos parámetros, se realiza una validación de la latencia para confirmar que el flujo de datos es constante. Este proceso garantiza que la infraestructura pueda absorber ráfagas de tráfico sin degradar el rendimiento.
Optimizar rendimiento IA y estrategias de infraestructura
Un administrador de sistemas revisa las gráficas de consumo energético y de procesamiento. El objetivo es encontrar el punto de equilibrio donde la eficiencia sea máxima sin sacrificar la velocidad de respuesta.
Para optimizar rendimiento IA, es crucial entender la latencia de inferencia. Cada vez que un usuario realiza una consulta, el modelo debe procesar los datos, lo que consume tiempo y recursos.
Si la infraestructura no está bien diseñada, el tiempo de respuesta aumentará exponencialmente con cada nuevo usuario.
Las estrategias tráfico IA deben incluir la gestión de la latencia en el borde (edge computing). Al procesar parte de la lógica cerca del usuario, se reduce el tiempo de viaje de los datos.
Sin embargo, esto requiere una sincronización precisa con el núcleo del sistema para mantener la coherencia de la información.
Al aplicar estas estrategias, yo mismo he observado cómo la latencia se estabiliza incluso cuando el número de usuarios aumenta de forma impredecible. La clave reside en la capacidad de respuesta de la infraestructura ante la variabilidad de la carga.
El tema de esta sección es AI web tráfico alto.
El mismo tema también se llama manejo tráfico IA.
Artículos relacionados
- Optimización AI web servicio: Guía para elegir entre IaaS y PaaS
- Diseño tarifas web IA: Mejores consejos para la rentabilidad
¿Qué implicaciones tiene el despliegue de una infraestructura con alto tráfico AI web?
El despliegue de una infraestructura capaz de soportar un AI web tráfico alto conlleva la necesidad de anticipar puntos de fallo y diseñar mecanismos de recuperación robustos. La planificación técnica rigurosa debe contemplar escenarios de sobrecarga para asegurar que la experiencia del usuario permanezca inalterada incluso durante picos inesperados de demanda.
La gestión de la carga de procesamiento debe ser proactiva, lo que significa monitorear constantemente las métricas de rendimiento para intervenir antes de que se alcancen umbrales críticos.
Si se omite esta vigilancia, la arquitectura escalable diseñada puede verse comprometida ante una avalancha de peticiones simultáneas.
La disponibilidad de los recursos es un factor crítico en este despliegue, pues cualquier indisponibilidad afecta directamente la capacidad de respuesta del sistema de inteligencia artificial.
Por ello, la redundancia de componentes se convierte en un requisito no negociable para mantener la operatividad continua.





Comentarios 0