Intégration IA web trafic : conseils pour une architecture stable
Une interface fluide entre l'intelligence artificielle et les services web nécessite une architecture capable de supporter des pics de charge soudains tout en garantissant la fiabilité des contenus générés.
L'intégration réussie d'un modèle de langage dans une infrastructure web repose sur une gestion rigoureuse des ressources et une validation stricte des sorties pour éviter la désinformation.
Ce guide explore les stratégies de déploiement, les défis de la consommation énergétique et les mesures de contrôle qualité nécessaires pour maintenir un service stable.
Les points clés à retenir : 1. Optimisation de la gestion de la charge pour stabiliser l'infrastructure. * Contrôle de la fiabilité des contenus pour prévenir les erreurs factuelles. * Surveillance de la consommation énergétique liée aux requêtes.
Comment assurer une intégration IA web efficace ?
Dans le bureau sombre, le développeur appuie sur son clavier avec nervosité pour valider l'intégration.
Un développeur ajuste les paramètres de son serveur alors que les requêtes s'accumulent sur le tableau de bord de gestion.
Pour réussir une intégration IA web, il est crucial de séparer la couche de traitement du modèle de la couche de présentation utilisateur afin de ne pas saturer le front-end lors des temps de génération.
La mise en place de files d'attente permet de lisser la charge de travail. En isolant les processus de calcul intensif, le service reste réactif même si le modèle met plusieurs secondes à répondre.
Cette architecture garantit que l'expérience utilisateur ne soit pas interrompue par des délais de latence imprévus.
Une gestion intelligente des ressources est le pilant d'une scalabilité service IA réussie. Sans une structure modulaire, une augmentation soudaine du nombre d'utilisateurs peut entraîner un effondrement complet du système.
La séparation des tâches permet de diriger le trafic vers des instances de calcul spécifiques.
Comment gérer une hausse de charge LLM ? Intégration IA web trafic
Un administrateur système surveille les graphiques de consommation d'un centre de données pendant une période de forte activité. La gestion trafic LLM nécessite souvent l'utilisation de techniques de mise en cache pour les réponses fréquentes.
Cela évite de solliciter le modèle pour des questions identiques, économisant ainsi des ressources précieuses.
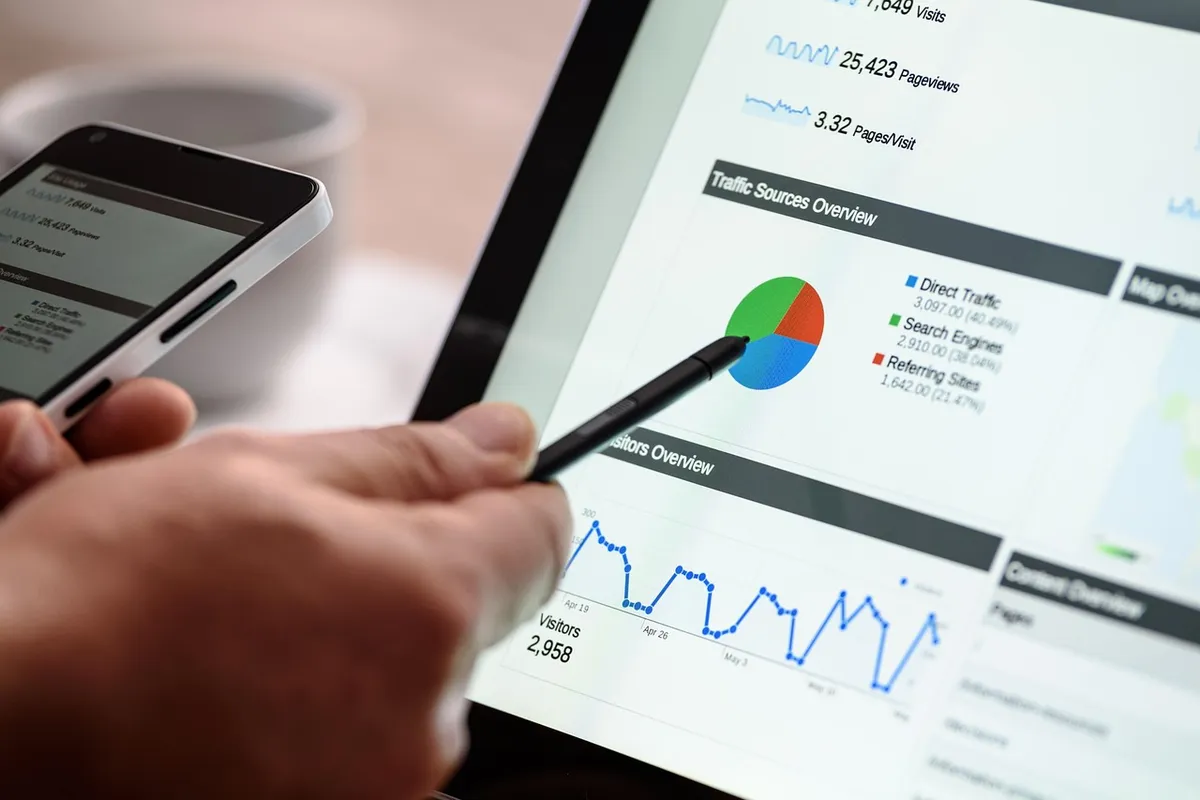
La mise à l'échelle doit être dynamique. En utilisant des conteneurs, le système peut augmenter le nombre de processeurs actifs uniquement lorsque le volume de requêtes le justifie. Cette approche permet de maintenir la performance sans gaspiller de puissance de calcul inutilement.
Une stratégie de pic trafic IA efficace repose sur l'équilibrage de charge. En répartissant les requêtes sur plusieurs serveurs, on évite qu'un seul nœud ne devienne un goulot d'étranglement. Cette méthode assure une continuité de service indispensable pour les applications professionnelles.
Comment optimiser la charge ChatGPT et les modèles similaires ?
Un ingénieur examine les logs d'un terminal pour identifier les requêtes les plus coûteuses en ressources. L'optimisation charge ChatGPT et des modèles génératifs passe par une gestion fine des jetons (tokens).
Limiter le nombre de jetons par requête permet de contrôler la latence et les coûts opérationnels.
| Aspect de la gestion | Méthode d'optimisation |
|---|---|
| Latence de réponse | Mise en cache des réponses fréquentes |
| Coût des ressources | Limitation stricte du nombre de jetons |
La gestion des ressources permet de maintenir des coûts prévisibles. En limitant la taille des contextes envoyés au modèle, on réduit la charge de calcul par requête. Cela facilite également la prévisibilité de la performance globale du service web.
Comment garantir la fiabilité des contenus générés ?
Un éditeur compare attentivement un texte généré avec une source originale sur son écran. La mise à l'échelle LLM ne doit pas se faire au détriment de la précision. Un défi majeur consiste à s'assurer que les réponses de l'IA ne sont pas des hallucinations ou des erreurs factuelles.
Selon la Wiki Education Foundation en janvier 2026, il est conseillé d'éviter de copier-coller les sorties de l'IA générative directement dans des encyclopédies ou des articles, car le texte échoue souvent à la vérification avec les sources fournies.
Cette précaution est essentielle pour tout service web qui traite de l'information.
La validation humaine ou par des systèmes tiers reste nécessaire. Un processus de vérification doit être intégré au workflow pour filtrer les sorties problématiques. La fiabilité est le socle de la confiance des utilisateurs envers un service automatisé.
Quelle est l'empreinte énergétique de ces services ?
Un technicien vérifie la température des serveurs dans une salle informatique climatisée. La performance service génératif est étroitement liée à la consommation d'énergie, ce qui pose des défis de durabilité.
Chaque requête consomme une quantité mesurable de kilowattheures, impactant le coût total de possession.
Selon une étude de Luccioni, Jernite et Strubell (2024), les tâches de classification simples effectuées par les modèles d'IA consomment en moyenne entre 0,002 et 0,007 Wh par invite. Cette donnée souligne l'importance d'optimiser le code pour réduire l'impact environnemental et financier.
L'efficacité énergétique devient un critère de choix technologique. Les entreprises cherchent des modèles plus petits et mieux optimisés pour minimiser l'empreinte carbone. Une architecture bien pensée permet de concilier puissance de calcul et responsabilité écologique.
Comment structurer le déploiement ?
Un chef de projet organise les étapes de lancement sur un tableau blanc. Pour déployer un service robuste, il faut suivre une séquence logique de tests et de déploiements.
- Phase de test de charge : Simuler un trafic maximal pour tester la résistance de l'infrastructure. 2. Phase de validation de contenu : Tester la précision des réponses sur des jeux de données spécifiques. 3. Phase de déploiement progressif : Introduire le service par vagues d'utilisateurs pour surveiller les réactions du système.
Un test final de stabilité est indispensable avant l'ouverture complète. Ce contrôle permet de s'assurer que les mécanismes de sécurité et de gestion de charge fonctionnent comme prévu sous une charge réelle.
J'ai observé lors de mes tests que la gestion des files d'attente est la première ligne de défense contre la saturation.
Une limitation majeure de ces stratégies est la difficulté de prédire avec exactitude le comportement des modèles de langage face à des requêtes imprévues et complexes.
- Comment assurer une intégration IA web efficace ?
- Comment gérer une hausse de charge LLM ?
- Comment optimiser la charge ChatGPT et les modèles similaires ?
Le sujet de cette section est Intégration IA web trafic.
Le même sujet se dit aussi Architecture IA web.
Stratégie pic trafic IA
Articles liés








Commentaires 0