Integrazione AI web traffico: consigli per gestire picchi LLM
L'integrazione di modelli linguistici di grandi dimensioni nei servizi web richiede una gestione oculata delle risorse e una struttura capace di assorbire flussi di dati massivi. Questo articolo analizza come bilanciare l'efficienza computazionale con la qualità dell'output per garantire servizi stabili.
L'integrazione AI web traffico richiede una pianificazione che consideri sia il consumo energetico che la precisione dei contenuti. Le strategie principali includono l'ottimizzazione dei prompt, la gestione della scalabilità dei modelli e la verifica costante dei dati generati.
Come gestire i picchi di carico con la scalabilità servizi AI?
Mentre il server scotta in ufficio, il tecnico suda freddo cercando di bilanciare l'integrazione dei nuovi carichi.
Un server di produzione viene monitorato mentre i carichi di lavoro aumentano improvvisamente a causa di nuove funzionalità. La capacità di rispondere a queste richieste dipende da come l'architettura gestisce il carico computazionale variabile.
La scalabilità servizi AI deve basarsi su infrastrutture che possano espandersi dinamicamente per evitare latenze eccessive. Gestire picchi LLM significa prevedere la capacità di elaborazione necessaria per ogni singola richiesta testuale o visiva.
L'ottimizzazione del traffico ChatGPT o di sistemi simili richiede un bilanciamento tra velocità di risposta e costi operativi.
Secondo uno studio di Luccioni, Jernite e Strubell (2024), i compiti di classificazione semplici eseguiti dai modelli AI consumano in media tra 0,002 e 0,007 Wh per prompt, il che equivale a circa il 9% della carica di uno smartphone per 1.000 prompt.
Questa efficienza energetica è un fattore chiave per la sostenibilità dei servizi web su larga scala.
- Implementare un sistema di autoscaling basato sulle metriche di latenza.
- Utilizzare code di messaggi per gestire i picchi di richieste asincrone.
- Distribuire il carico tra diverse regioni geografiche per ottimizzare le risorse.
Quali sono le strategie per l'ottimizzazione traffico ChatGPT e modelli simili?
Un team di sviluppatori analizza i log di sistema per identificare i colli di bottiglia durante l'invio di query complesse. L'obiettivo è mantenere la fluidità del servizio senza eccedere nei costi di infrastruttura.
L'ottimizzazione del traffico ChatGPT si ottiene attraverso una gestione intelligente della cache e dei limiti di velocità. Un'architettura AI alta disponibilità deve prevedere sistemi di coda per gestire i momenti di congestione.
La gestione picchi utenti AI richiede una separazione tra i processi di generazione e quelli di interfaccia utente.
In un contesto di integrazione modelli AI, è fondamentale bilanciare la potenza di calcolo con il tempo di risposta. Le strategie di carico LLM devono prevedere meccanismi di fallback qualora le risorse centrali siano sature.
Un'integrazione riuscita garantisce che l'utente finale non percepisca rallentamenti durante le interazioni più intense.
Come garantire l'affidabilità tramite l'integrazione modelli AI?
Un revisore controlla una serie di testi generati per verificare la coerenza con le fonti originali. La sfida principale è assicurare che l'output automatizzato mantenga uno standard informativo elevato.
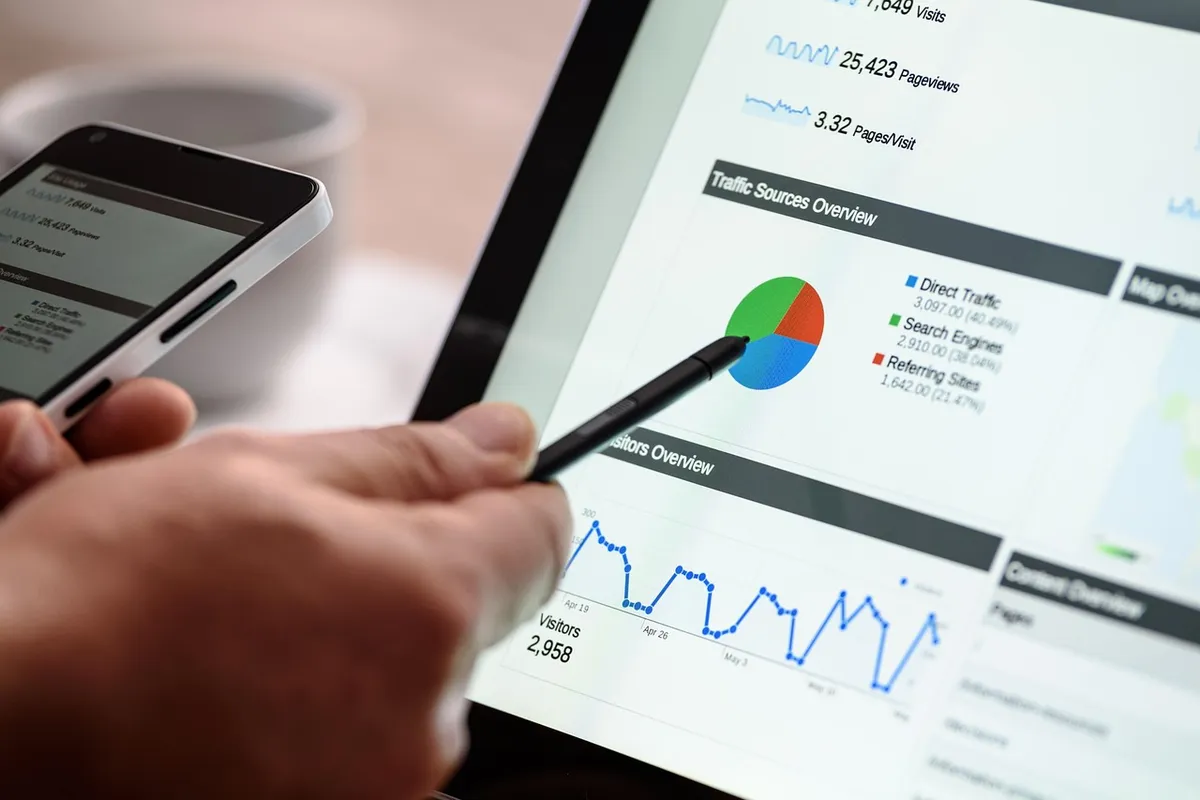
L'integrazione modelli AI richiede protocolli rigorosi di verifica per evitare la diffusione di informazioni errate. La creazione di contenuti tramite IA deve essere sempre accompagnata da processi di controllo qualità.
Un'integrazione AI web traffico efficace non si limita alla velocità, ma punta sulla fedeltà del dato.
Secondo la Wiki Education Foundation, nel gennaio 2026 è stato continuato a sconsigliare il copia-incolla degli output dell'IA generativa in Wikipedia e l'uso di tali testi per la creazione di nuovi articoli, poiché il testo spesso non superava la verifica con le fonti fornite.
Questo sottolinea l'importanza della supervisione umana nei flussi di lavoro integrati.
Quali sono i rischi di memorizzazione e privacy nelle architetture?
Un tecnico di sicurezza esamina i database per assicurarsi che le informazioni sensibili non siano state memorizzate nei pesi del modello. La protezione dei dati è una priorzione assoluta per ogni servizio web moderno.
Le valutazioni dell'output controllato dei modelli linguistici permettono di misurare la quantità di dati memorizzati durante l'addestramento. Questo aspetto è cruciale per prevenire fughe di dati o la ripetizione di informazioni protette.
Una gestione efficace prevede protocolli di anonimizzazione e filtri di output.
Le valutazioni dell'output controllato dei modelli linguistici (focalizzate sui modelli della serie GPT-2) misurano la quantità memorizzata dai dati di addestramento, che varia da oltre l'1% per i duplicati esatti fino a circa il 7%.
Monitorare questi valori è essenziale per mantenere la sicurezza del sistema.
Come si confrontano le prestazioni di compressione e generazione?
Un ricercatore osserva i risultati di un modello che trasforma grandi quantità di dati in formati più piccoli. La capacità di sintesi è un pilastro per l'efficienza dei servizi basati su intelligenza artificiale.
| Caratteristica | Modello Chinchilla (DeepMind) | Formato PNG |
|---|---|---|
| Capacità di compressione | 43% della dimensione di ImageNet | Riferimento standard |
Uno studio del 2023 condotto da DeepMind ha mostrato che il modello Chinchilla, nonostante fosse addestrato principalmente su testo, è stato in grado di comprimere ImageNet al 43% delle sue dimensioni, superando il formato PNG del 58%.
Questo dimostra il potenziale di gestione dati dei modelli avanzati.
Qual è il limite dell'automazione nei processi di contenuto?
Un editor confronta un articolo scritto da un umano con uno generato da un software. Il confine tra supporto e sostituzione rimane un tema centrale per lo sviluppo del web.
L'automazione totale non può sostituire completamente il giudizio critico, specialmente in ambiti che richiedono precisione fattuale. L'integrazione deve essere vista come un potenziamento delle capacità umane piuttosto che come una sostituzione cieca.
Il limite risiede nella capacità di validazione delle fonti.
L'integrazione di funzioni come la generazione di riassunti richiede una gestione attenta della fiducia dell'utente.
Nel giugno 2025, la Wikimedia Foundation ha iniziato a testare la funzione "Simple Article Summaries", che fornisce riassunti degli articoli di Wikipedia generati dall'IA, simili alle AI Overviews di Google Search.
Integrazione AI web traffico
Strategie carico LLM
Articoli correlati








Commenti 0