AI web tráfego alto: dicas para gerenciar o aumento de acessos
"A infraestrutura digital é o alicerce que sustenta a inovação, mas é a capacidade de resposta sob pressão que define o sucesso de um serviço."
Para lidar com o aumento repentino de usuários, é fundamental implementar estratégias de escalabilidade e arquitetura robusta que permitam o gerenciamento de recursos em tempo real. O objetivo é garantir que a infraestrutura suporte o crescimento sem comprometer a experiência do usuário final.
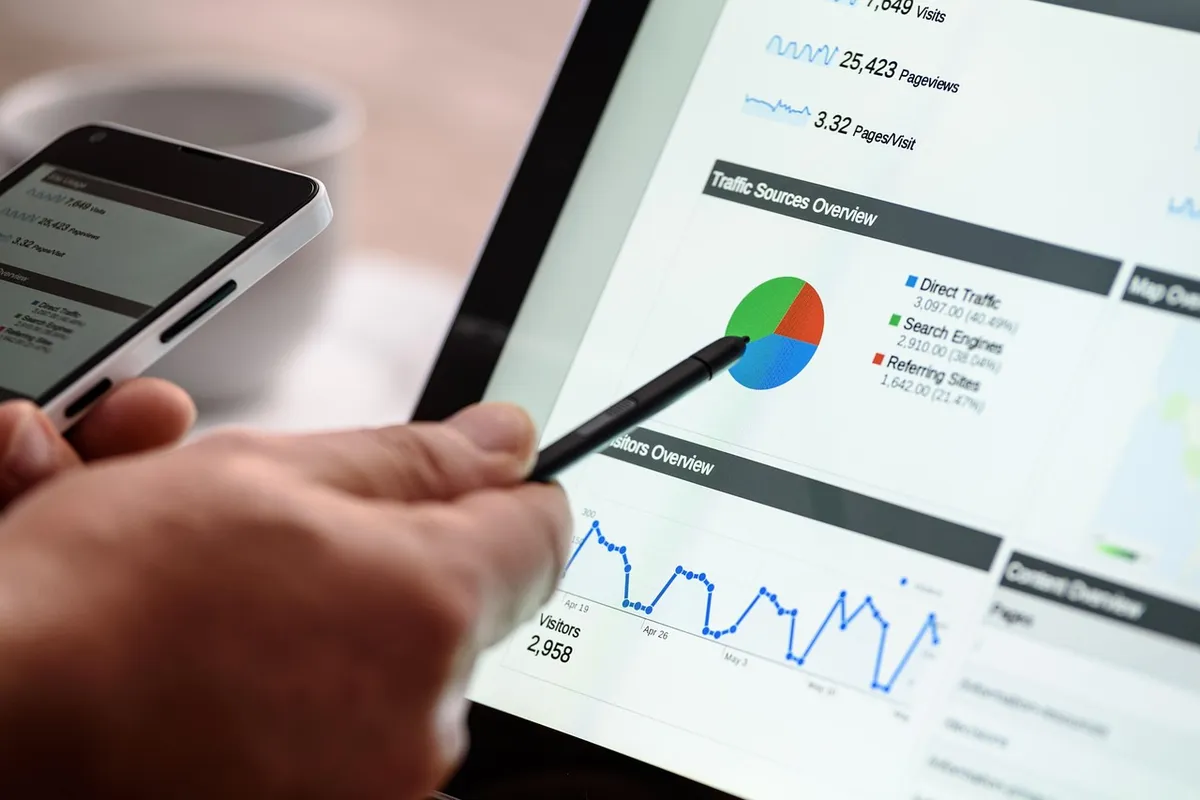
Os pontos principais incluem o uso de arquiteturas flexíveis, o balanceamento de carga inteligente e a otimização de recursos para manter a continuidade operacional.
Como gerenciar o AI web tráfego alto?
Ao meio-dia, no escritório silencioso, sinto o fego crescer enquanto meus dedos batem freneticamente no teclado diante do monitor brilhante.
O monitoramento constante de servidores durante um pico de acessos é uma tarefa que exige precisão técnica e agilidade. Em um cenário de crescimento súbito, o gerenciamento de recursos deve ser automático para evitar a queda do sistema.
A escalabilidade AI serviços é o primeiro passo para garantir que a infraestrutura cresça conforme a demanda aumenta. Quando o volume de requisições sobe, o sistema deve ser capaz de alocar novos recursos de forma fluida.
Para garantir estabilidade IA, os desenvolvedores precisam prever gargalos em bancos de dados e APIs. Um sistema que não se adapta rapidamente ao volume de dados pode sofrer latência severa ou interrupções totais.
A estratégia de lidar com pico de acesso envolve o uso de filas de mensagens e sistemas de cache para suavizar os picos de carga. Isso evita que o processamento central seja sobrecarregado durante momentos de uso intenso.
Além disso, a capacidade processamento IA deve ser dimensionada para suportar modelos de linguagem e tarefas pesadas de computação. Sem um planejamento de hardware ou nuvem adequado, a resposta aos comandos dos usuários pode se tornar lenta.
Como criar uma arquitetura para tráfego massivo?
O desenho de um sistema robusto começa na definição de como os componentes se comunicam sob estresse. Um arquiteto observa o fluxo de dados saindo de um terminal e entrando em um cluster de servidores.
Uma arquitetura para tráfego massivo exige a separção de serviços para que falhas isoladas não derrubem toda a plataforma. O uso de microsserviços permite que partes específicas do sistema sejam escaladas independentemente.
A otimização de performance IA foca em reduzir o tempo de resposta entre a entrada do usuário e o processamento do modelo. Ajustar os parâmetros de inferência e o uso de GPU é essencial para manter a fluidez.
A implementação de estratégias de balanceamento de carga distribui as requisições de forma equitativa entre os servidores disponíveis. Isso impede que um único nó seja sobrecarregado enquanto outros permanecem ociosos.
Ao configurar um ambiente de teste, eu observei como a distribuição de carga impacta diretamente a latência percebida pelo usuário. Ajustar o balanceador é um exercício constante de equilíbrio entre custo e performance.
Como implementar a escalabilidade passo a passo?
Durante a madrugada, no escritório escuro, meus dedos tremem com o fego de configurar cada novo nó de processamento. A configuração de novos servidores em um ambiente de nuvem exige um processo estruturado para evitar erros de integração. O administrador acessa o painel de controle para iniciar o provisionamento.
- Implemente o auto-scaling baseado em métricas de CPU e memória para automatizar o crescimento do cluster. 2. Utilize sistemas de cache distribuído para armazenar resultados de consultas frequentes e reduzir o esforamento do processamento principal. 3. Configure limites de taxa (rate limiting) para proteger os serviços contra abusos ou picos descontrolados de acessos.
Ao finalizar a configuração, é necessário realizar um check de integridade para garantir que a nova carga está sendo distribuída corretamente.
Comparativo de abordos de escalonamento
A escolha entre modelos de escalonamento impacta diretamente o custo operacional e a velocidade de resposta.
| Tipo de Escalonamento | Principal Benefício | Contexto de Uso |
|---|---|---|
| Vertical (Scale-up) | Aumento imediato de poder | Servidores de banco de dados |
| Horizontal (Scale-out) | Flexibilidade e redundância | Clusters de aplicação web |
A decisão de expandir verticalmente ou horizontalmente depende da natureza da carga de trabalho e do orçamento disponível.
Limitações do gerenciamento de carga
O planejamento de infraestrutura deve considerar que o crescimento infinito não é possível sem um limite de custo ou de hardware físico.
Uma limitação importante ocorre quando o gargalo não está no processamento, mas na largura de banda de rede ou em serviços de terceiros que não permitem escalonamento imediato.
- Como gerenciar o AI web tráfego alto?
- Como criar uma arquitetura para tráfego massivo?
- Como implementar a escalabilidade passo a passo?
O tema desta seção é AI web tráfego alto.
Artigos relacionados
- Otimização AI web serviço: Guia de modelos de serviço em nuvem
- Preços IA: como criar planos de preços IA para receita estável
Como a infraestrutura digital suporta o crescimento?
O suporte ao crescimento da infraestrutura digital depende da capacidade de resposta sob pressão, que é o fator definidor do sucesso do serviço. A implementação de arquiteturas flexíveis permite que o sistema absorva aumentos de demanda sem falhas. O balanceamento de carga inteligente garante que os recursos sejam distribuídos de modo eficiente entre os componentes disponíveis.
A otimização de recursos é crucial para manter a continuidade operacional mesmo quando a demanda cresce exponencialmente. Isso envolve ajustar os parâmetros de inferência e o uso de GPU, especialmente em tarefas de computação pesada.
A infraestrutura precisa ser dimensionada para lidar com modelos de linguagem sem lentidão perceptível pelo usuário.
Quais são os riscos de uma arquitetura não otimizada?
Um sistema sem adaptação rápida ao volume de dados pode enfrentar latência severa ou até mesmo interrupções totais. A falta de separação de serviços, por exemplo, faz com que uma falha isolada derrube toda a plataforma. O planejamento inadequado de hardware ou nuvem compromete a resposta aos comandos dos usuários.
O gerenciamento de recursos deve ser automático em cenários de crescimento súbito para evitar a queda do sistema. Se os gargalos não forem previstos em bancos de dados e APIs, a estabilidade da infraestrutura é ameaçada.
É preciso considerar que o crescimento ilimitado sempre encontrará um limite de custo ou de hardware físico.





Comentários 0