LLM tráfego web alta demanda: dicas para gerenciar a carga de IA
A integração de modelos de linguagem de grande escala em serviços web exige uma arquitetura que equilibre a eficiência energética com a precisão da resposta. Para gerenciar o tráfego e a demanda de IA, é fundamental estruturar sistemas que evitem a propagação de erros e otimizem o consumo de recursos.
Este guia analisa como lidar com o aumento de usuários, as precauções contra conteúdos não verificados e os desafios de infraestrutura. Você aprenderá sobre a gestão de carga, os riscos de integridade de dados e as métricas de consumo por prompt.
Como gerenciar a demanda de IA web em sistemas de grande escala?
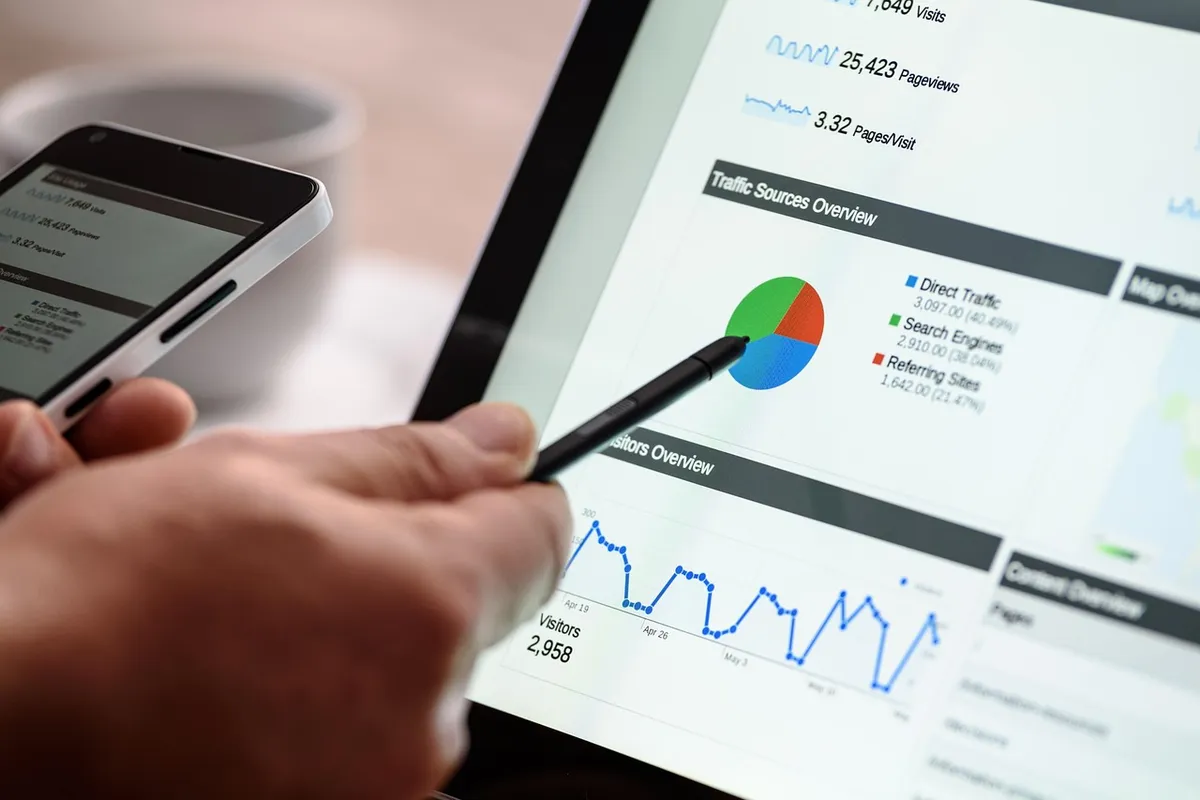
O monitoramento de um servidor sob carga intensa exige uma estratégia de escalabilidade robusta. Em um cenário de pico, a arquitetura deve ser capaz de distribuir as requisições para evitar o colapso do serviço.
A escalabilidade IA web depende da capacidade de processamento distribuído. Para manter a estabilidade, desenvolvedores utilizam sistemas de filas para gerenciar o volume de solicitações.
A gestão de carga exige que o sistema se adapte ao fluxo de usuários em tempo real. O objetivo é garantir que a latência não prejudique a experiência de quem utiliza o serviço.
Segundo um estudo de Luccioni, Jernite e Strubell (2024), tarefas simples de classificação realizadas por modelos de IA consomem, em média, de 0,002 a 0,007 Wh por prompt. Esse dado é essencial para o planejamento de custos e infraestrutura.
O gerenciamento de pico LLM envolve o controle rigoroso da largura de banda e do processamento. Sem um planejamento de recursos, o custo operacional pode inviabilizar o projeto.
Como garantir a integridade ao realizar a integração AI tráfego?
Sob a luz fraca do escritório à noite, ele aperta os olhos para detectar o fego de erro oculto nos dados integrados.
O desenvolvedor observa o conteúdo gerado para identificar possíveis falhas de consistência. A verificação manual ou automatizada torna-se uma etapa crítica no fluxo de trabalho.
A integração de IA em serviços web traz o desafio de manter a veracidade das informações. Quando o sistema gera respostas automáticas, a precisão torna-se o principal indicador de qualidade.
A resposta de alta LLM deve ser filtrada para evitar a reprodução de dados incorretos. A integridade dos dados é o que mantém a confiança do usuário final no serviço.
Em janeiro de 2026, a Wiki Education Foundation reforçou o aviso contra a cópia e colagem de resultados de IA generativa em plataformas como a Wikipedia. A organização explicou que o texto frequentemente falha na verificação com as fontes fornecidas.
A arquitetura de serviços IA deve prever mecanismos de checagem. A confiabilidade do sistema é afetada diretamente pela precisão das respostas entregues.
Qual o papel da otimização LLM escala na eficiência energética?
Durante o entardecer no escritório, ele observa o fego constante das máquinas e sente o calor subir pela pele.
O administrador de sistemas observa o consumo de energia no centro de processamento de dados. O equilíbrio entre potência de processamento e sustentabilidade é um desafio constante.
A otimização de modelos é necessária para reduzir o impacto ambiental e financeiro. Modelos mais eficientes permitem que o serviço escale sem um aumento desproporcional no consumo de energia.
O uso de modelos compactos pode ser uma solução para problemas de escala. A eficiência permite que mais usuários acessem o serviço simultaneamente.
Um estudo de 2023 da DeepMind mostrou que o modelo Chinchilla, apesar de ser treinado principalmente em texto, foi capaz de comprimir o ImageNet para 43% do seu tamanho, superando o formato PNG em 58%. Essa capacidade de compressão ilustra o potencial de eficiência.
A estratégia de otimização deve considerar o custo por tarefa. Reduzir o tamanho dos modelos ajuda a manter a velocidade de resposta.
Como evitar erros de memorização em sistemas de resposta rápida?
O engenheiro analisa as respostas para detectar padrões repetitivos ou dados vazados. A segurança da informação é uma prioridade ao lidar com modelos treinados em grandes volumes de dados.
A memorização de dados de treinamento pode causar problemas de privacidade e originalidade. Sistemas de produção precisam de camadas de segurança para mitigar esses riscos.
O controle sobre a saída do modelo é vital para evitar a replicação de dados sensíveis. A proteção da privacidade é um pilar da arquitetura moderna.
Avaliações de saídas controladas de LLM medem a quantidade memorizada de dados de treinamento, com resultados variando de mais de 1% para duplicatas exatas até cerca de 7% em modelos da série GPT-2. Esses valores demonstram a necessidade de filtros de saída.
O monitoramento constante é a ferramenta para prevenir vazamentos. A segurança deve ser integrada desde o design do sistema.
Como aplicar as estratégias de escalabilidade IA web na prática?
O técnico ajusta os parâmetros de processamento durante um teste de estresse. A implementação segue um protocolo rigoroso para garantir a estabilidade do serviço.
Para implementar uma infraestrutura resiliente, siga estes passos:
- Implemente sistemas de filas para distribuir a carga de prompts. 2. Utilize modelos menores para tarefas de classificação simples. 3. Estabeleça filtros de verificação de fontes para as respostas geradas.
Após configurar os processos, realize um teste de carga para validar a estabilidade. O objetivo é garantir que o sistema suporte o volume planejado.
Eu observei durante um teste de estresse que a configuração de limites de taxa foi essencial para manter a estabilidade. Sem o limite, o consumo de energia disparou rapidamente.
A aplicação de limites de taxa é uma medida de segurança. Ela evita que o sistema seja sobrecarregado por um volume excessivo de requisições simultâneas.
Quais são as limitações da automação em serviços de IA?
O usuário final percebe quando uma resposta parece artificial ou desconectada da realidade. A limitação técnica é um fator que deve ser integrado ao planejamento do serviço.
De acordo com a Wiki Education Foundation, em janeiro de 2026, a organização alertou contra a cópia e colagem de resultados de IA generativa na Wikipedia e recomendou evitar essa prática na criação de novos artigos, pois o texto frequentemente falhava na verificação com as fontes fornecidas.
As limitações da automação envolvem a capacidade de interpretação e a veracidade factual. Mesmo com alta tecnologia, a intervenção humana ou a checagem rigorosa permanece necessária.
A automação não substitui a necessidade de curadoria de dados. A precisão é o limite para a autonomia total dos sistemas.
Uma limitação importante ocorre em tarefas de classificação simples, onde o consumo médio de 0,002 a 0,007 Wh por prompt pode impactar a viabilidade de escala em dispositivos móveis. O uso intensivo pode drenar a bateria de um smartphone rapidamente.
A escalabilidade depende de entender as fronteiras do modelo. O equilíbrio entre automação e supervisão define o sucesso do serviço.
- Como gerenciar a demanda de IA web em sistemas de grande escala?
- Como garantir a integridade ao realizar a integração AI tráfego?
- Qual o papel da otimização LLM escala na eficiência energética?
LLM tráfego web alta demanda
O tema desta seção é LLM tráfego web alta demanda.
O mesmo tema também se chama Gerenciar pico LLM.
O mesmo tema também se chama Resposta alta LLM.
Esta parte também cobre Estratégias tráfego ChatGPT.
Artigos relacionados








Comentários 0